شروع سفر آموزشی...
در ادامه، یک کتاب بسیار ارزشمند در حوزه پردازش زبان طبیعی رو معرفی میکنم که خوندش برای هر کسی که میخواد در این حوزه فعالیت کنه از واجباته!
معرفی کتاب: Practical Natural Language Processing
کتاب "Practical Natural Language Processing: A Comprehensive Guide to Building Real-World NLP Systems" یکی از منابع مرجع و بسیار کاربردی در دنیای پردازش زبان طبیعی است. این کتاب توسط Sowmya Vajjala و همکاران تألیف شده و تمرکز اصلی آن بر روی چرخه حیات واقعی پروژههای NLP، از مرحله جمعآوری داده تا استقرار در محیطهای عملیاتی است.
درباره نویسندگان
نویسندگان این کتاب ترکیبی از متخصصان صنعت و محققان برجسته در گوگل و شرکتهای پیشرو تکنولوژی هستند که تجربیات خود را در چالشهای دنیای واقعی به اشتراک گذاشتهاند.
سرفصلها
- فصل ۱ تا ۳: مقدمات، چرخه حیات پروژه و مدیریت دادههای متنی.
- فصل ۴ و ۵: استخراج ویژگیها، تکنیکهای کلاسیک و یادگیری ماشین در NLP.
- فصل ۶ و ۷: یادگیری عمیق، شبکههای عصبی و تحول با مدلهای ترنسفورمر (BERT, GPT).
- فصل ۸ و ۹: یادگیری انتقال (Transfer Learning) و تکنیکهای تولید متن (Text Generation).
- فصل ۱۰: اخلاق، تفسیرپذیری و چالشهای آینده در پردازش زبان.
من به عنوان یک علاقهمند به دنیای هوش مصنوعی و پردازش زبان طبیعی (NLP)، در این فضا قصد دارم مفاهیم اولیه و کاربردی این حوزه را با شما به اشتراک بگذارم. هدف من، سادهسازی مسیر یادگیری برای کسانی است که میخواهند از تئوریهای آکادمیک فراتر رفته و وارد دنیای ساخت سیستمهای هوشمند واقعی شوند.
برای شروع این سفر آموزشی، ابتدا تصمیم دارم فصل اول کتاب مرجع "Practical Natural Language Processing" را برایتان تحلیل و خلاصهسازی کنم. درک عمیق این فصل، پایهایترین گام برای شناخت چالشها و فرصتهایی است که در پروژههای NLP با آنها مواجه خواهیم شد.
پردازش زبان طبیعی (NLP): از مفاهیم تا کاربردها
۱. چیستی و فلسفه وجودی NLPپردازش زبان طبیعی (Natural Language Processing) یا به اختصار NLP، حوزهای میانرشتهای از علوم کامپیوتر، هوش مصنوعی و زبانشناسی است. هدف غایی این دانش، دستیابی به تعاملی بینقص و طبیعی میان انسان و ماشین است؛ به طوری که کامپیوتر بتواند دادههای زبانی را نه به عنوان رشتهای از کاراکترها، بلکه به عنوان حاملهای معنایی درک کند.
تفاوت بنیادین در اینجاست که زبانهای برنامهنویسی دارای قواعد نحوی صریح، منطقی و بدون ابهام هستند، اما زبانهای طبیعی که طی هزارهها تکامل یافتهاند، طبیعتی منعطف، پویا و به شدت "وابسته به زمینه" دارند. NLP پلی است برای ترجمه این پیچیدگی انسانی به منطق ریاضی و مدلهای آماری/عصبی که ماشینها قادر به پردازش آن هستند.
۲. لایههای ساختاری و بلوکهای سازنده زبان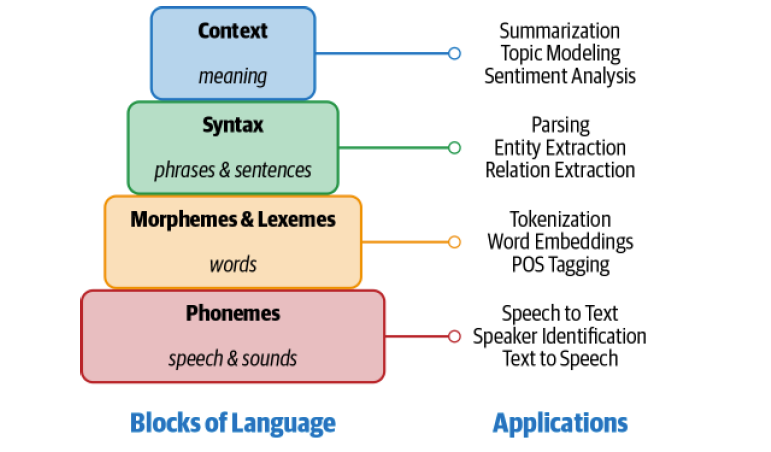
برای اینکه یک ماشین بتواند زبان را تحلیل کند، ما باید زبان را به سطوح مختلفی تجزیه کنیم:
الف) تحلیل آوایی (Phonology)در این سطح، سیستم روی واجها (Phonemes) تمرکز دارد که کوچکترین واحدهای صوتی متمایزکننده هستند. بدون درک دقیق این سطح، سیستمهای تشخیص گفتار (ASR) قادر به تمایز میان اصوات مشابه نخواهند بود.
ب) تحلیل ریختشناسی (Morphology)بررسی ساختار درونی کلمات؛ شامل نحوه ترکیب تکواژها (Morphemes) برای تشکیل واژگان (Lexemes). این مرحله شامل ریشهیابی و تحلیل وندها (پیشوندها و پسوندها) است که برای زبانهایی با ساختار کلمهای پیچیده، حیاتی است.
ج) تحلیل نحوی (Syntax)در این مرحله، قوانین چیدمان کلمات در جمله بررسی میشود. ابزارهای مدرن در اینجا از "درختهای تجزیه" (Parse Trees) استفاده میکنند تا نقشهای دستوری (مانند فاعل، مفعول، متمم) و روابط بین کلمات را به صورت سلسلهمراتبی نمایش دهند.
د) تحلیل معنایی و کاربردشناسی (Semantics & Pragmatics)پیچیدهترین سطح تحلیل که به معنای واقعی جملات میپردازد. در حالی که معناشناسی بر معنای واژگان و جملات تمرکز دارد، کاربردشناسی بررسی میکند که چگونه «زمینه» و «دانش جهانشمول» میتواند معنای یک جمله را تغییر دهد.
۳. چالشهای بنیادی در مسیر درک زبانچرا NLP همچنان یکی از دشوارترین مسائل هوش مصنوعی است؟
- ابهام (Ambiguity): یک کلمه ممکن است در زمینههای مختلف، تعاریف کاملاً متفاوتی داشته باشد (مثل واژه "شیر" در فارسی).
- خلاقیت و پویایی: زبان ثابت نیست. ابداع استعارهها، کنایهها و اصطلاحات جدید توسط انسان، مدلهای ایستا را با شکست مواجه میکند.
- فقدان عقل سلیم (Common Sense): ماشینها از حقایق بدیهی دنیای فیزیکی که انسانها از بدو تولد میآموزند بیبهرهاند، که این امر درک بسیاری از جملات روزمره را مختل میکند.
زبان، پدیدهای فراتر از قوانین صرف است؛ زبان ماهیتی خلاقانه دارد. سبکها، گویشها، ژانرها و گونههای متنوع، همگی بخشی از این ساختار پیچیده هستند. به عنوان مثال، اشعار نمونه بارزی از خلاقیت زبانی محسوب میشوند. وادار کردن ماشینها به درک این خلاقیت، نه تنها در حوزه NLP، بلکه در کلیت هوش مصنوعی، یک مسئله بسیار دشوار است.
علاوه بر این، برای اکثر زبانهای دنیا هیچ نگاشت مستقیمی بین واژگان وجود ندارد. این امر انتقال راهحلهای NLP از یک زبان به زبان دیگر را با چالش مواجه میکند؛ به طوری که یک مدل موفق برای یک زبان، ممکن است در زبانی دیگر کارایی نداشته باشد. این مسئله ما را بر سر دوراهی قرار میدهد: یا باید مدلهای زبان-مستقل (Language-Agnostic) بسازیم که از نظر مفهومی بسیار دشوار است، یا برای هر زبان راهحلهای جداگانهای طراحی کنیم که امری پرزحمت و زمانبر است. تمامی این چالشها، NLP را به حوزهای دشوار اما بسیار ارزشمند برای فعالیت تبدیل کرده است.
ارتباط یادگیری ماشین و یادگیری عمیق با NLP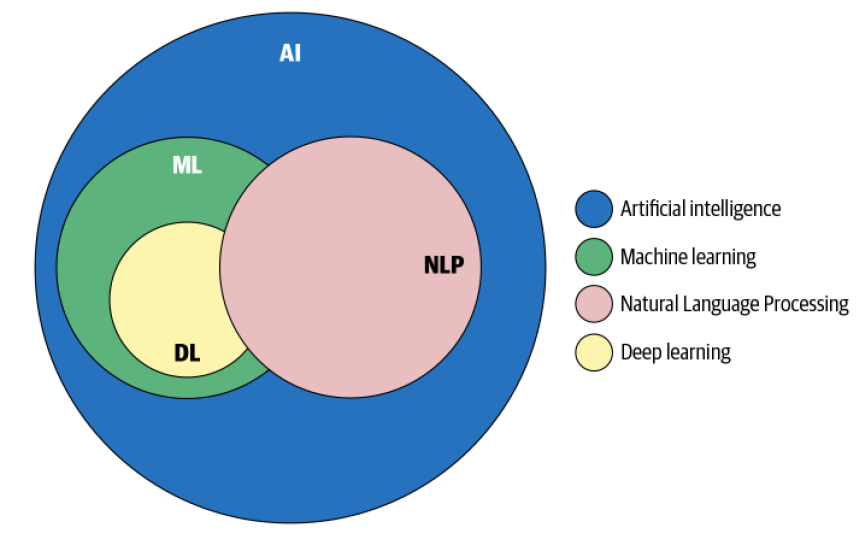
پیش از آنکه به سراغ حل چالشها برویم، باید رویکردهای رایج را بشناسیم. یادگیری ماشین (Machine Learning) در پی آن است که انجام وظایف را بر اساس مثالها (دادههای آموزشی یا Training Data) و بدون دستورالعملهای صریح به ماشین بیاموزد. این فرآیند معمولاً با ایجاد یک نمایش عددی از دادهها به نام ویژگیها (Features) انجام میشود.
الگوهای اصلی یادگیری ماشین
- یادگیری نظارتشده (Supervised Learning): هدف، یادگیری تابع نگاشت از ورودی به خروجی بر اساس جفتهای دادهای است که در آن خروجیها با نام برچسب (Label) یا حقیقت زمینه (Ground Truth) شناخته میشوند. (مثال: طبقهبندی ایمیلهای هرزنامه).
- یادگیری بدون نظارت (Unsupervised Learning): شناسایی الگوهای پنهان در دادههای بدون برچسب. (مثال: مدلسازی موضوعی که در فصل ۷ به آن خواهیم پرداخت).
- یادگیری نیمهنظارتی (Semi-supervised Learning): ترکیبی از مجموعه دادههای کوچک برچسبگذاریشده و مجموعه دادههای بزرگ بدون برچسب برای ارتقای دقت مدل.
- یادگیری تقویتی (Reinforcement Learning): یادگیری از طریق آزمون و خطا و سیستم پاداش و تنبیه محیطی. این روش هنوز در NLP کاربرد گستردهای ندارد و بیشتر در رباتیک و بازیهای ماشینی متداول است.
در کنار اینها، یادگیری عمیق (Deep Learning) به عنوان شاخهای از یادگیری ماشین، مبتنی بر معماریهای شبکههای عصبی مصنوعی است که از ساختار مغز انسان الهام گرفتهاند. در دهه اخیر، این معماریها موفقیتهای چشمگیری در تشخیص تصویر، ترجمه ماشینی و سایر کاربردهای NLP داشتهاند.
رویکردهای حل مسائل NLP
به طور کلی، رویکردهای حل مسائل NLP در سه دسته اصلی قرار میگیرند:
- رویکرد مبتنی بر اکتشافات (Heuristics-Based)
- رویکرد مبتنی بر یادگیری ماشین (Machine Learning-Based)
- رویکرد مبتنی بر یادگیری عمیق (Deep Learning-Based)
این رویکرد، یادآور تلاشهای اولیه هوش مصنوعی است. در این سیستمها، توسعهدهندگان با تکیه بر تخصص انسانی، قوانینی را تدوین کرده و در برنامه میگنجاندند. این سیستمها نیازمند منابعی چون فرهنگ لغت و اصطلاحنامههای دیجیتالی بودند. تحلیل احساسات بر اساس واژگان (Lexicon-based sentiment analysis)، نمونهای از طراحی قوانین برای حل مسائل در این دوران است.
۴. سیر تحول رویکردهای حل مسئله در NLPرویکرد اکتشافی (Heuristics)
این رویکرد که نسل اول NLP محسوب میشود، متکی بر قوانین دستی (If-Then)، فرهنگ لغتهای حجیم و عبارات باقاعده (Regex) است. اگرچه این روشها فاقد انعطاف هستند، اما در پروژههای صنعتی که نیاز به دقت ۱۰۰ درصدی در الگوهای خاص دارند، هنوز بیرقیباند.
یادگیری ماشین کلاسیک (ML)
در این مرحله، از روشهای آماری برای یادگیری الگوها استفاده میشود. الگوریتمهایی نظیر Naive Bayes و SVM برای دستهبندی متن، و مدلهای مارکوف (HMM) برای توالییابی کلمات، پایه و اساس پیشرفتهای این دوره بودند.
یادگیری عمیق (Deep Learning)
انقلاب بزرگ که با استفاده از شبکههای عصبی رخ داد. مدلهای RNN و LSTM برای مدیریت توالیها و بعدها معماری Transformer، دنیای NLP را متحول کردند. مکانیسم "توجه" (Attention) در این مدلها به ماشین اجازه میدهد وزنِ ارتباط کلمات دوردست در جمله را درک کند.
۵. محدودیتهای کلیدی مدلهای یادگیری عمیقعلیرغم قدرت بینظیر ترانسفورماتورها، کتاب به نکات انتقادی زیر اشاره میکند:
- بیشبرازش و دادهمحوری: این مدلها تشنهی دادههای عظیم هستند و بدون آن، دچار بیشبرازش (Overfitting) میشوند. جعبه سیاه بودن نیز مانع از تفسیرپذیری میشود؛ یعنی ما نمیدانیم مدل دقیقاً چگونه به یک نتیجهگیری خاص رسیده است. علاوه بر این، هزینههای پردازشی (GPU) و تأخیر در پاسخدهی (Latency)، استفاده از آنها را در دستگاههای کوچک یا سیستمهای حساس به زمان محدود میکند.
یک عامل محاورهای پیشرفته، مجموعهای از ماژولهای به هم پیوسته است:
- تشخیص گفتار (ASR): تبدیل سیگنال صوتی به متن نوشتاری.
- درک زبان (NLU): تحلیل احساسات، تشخیص موجودیتهای نامدار (NER) و تفکیک ضمایر (Coreference Resolution).
- تولید پاسخ (NLG): تبدیل مفاهیم منطقی به جملات روان و طبیعی.
در طول چند سال گذشته، DL (یادگیری عمیق) پیشرفتهای شگفتانگیزی در NLP داشته است. به عنوان مثال، در طبقهبندی متن، مدلهای مبتنی بر LSTM و CNN در بسیاری از وظایف، از عملکرد تکنیکهای استاندارد یادگیری ماشین مانند Naive Bayes و SVM پیشی گرفتهاند. به طور مشابه، مدلهای قدرتمند Transformer در حال حاضر به فناوری پیشرفته در اکثر این وظایف تبدیل شدهاند.
این رویکرد که به عنوان transfer learning شناخته میشود، بسیار موفق بوده است. با این وجود، یادگیری عمیق هنوز هم راه حل قطعی برای همه کاربردهای صنعتی نیست. برخی از دلایل اصلی این امر به شرح زیر است:
- ۱. بیشبرازش روی مجموعه دادههای کوچک (Overfitting): مدلهای DL پارامترهای بسیار زیادی دارند. در نبود دادههای آموزشی کافی، این مدلها به جای یادگیری الگوهای کلی، دچار بیشبرازش شده و قابلیت تعمیم خود را از دست میدهند. در چنین مواردی، مدلهای سادهتر ترجیح داده میشوند.
- ۲. یادگیری چند مرحلهای و دادههای مصنوعی: در حوزههایی مثل بینایی کامپیوتر، پیشرفتهای خوبی در یادگیری از نمونههای بسیار کم (Few-shot learning) رخ داده است، اما ما هنوز شاهد توسعه موفقیتآمیز تکنیکهای مشابه برای NLP نبودهایم.
- ۳. انطباق دامنه (Domain Adaptation): مدلهای DL که بر روی متون عمومی آموزش دیدهاند، هنگام اعمال در حوزههای تخصصی (مانند قانون یا پزشکی) به دلیل تفاوت در ساختار نحوی و معنایی، عملکرد ضعیفی دارند.
- ۴. مدلهای قابل تفسیر (Interpretable models): مدلهای DL اغلب به عنوان یک جعبه سیاه (Black Box) عمل میکنند. برای کسبوکارها، توضیحپذیری نتیجه برای مشتری حیاتی است؛ کاری که تکنیکهای سنتی بهتر انجام میدهند.
- ۵. عقل سلیم و دانش جهانی (Common Sense): زبان برای برقراری ارتباط به استدلال منطقی و دانش جهان متکی است. مدلهای فعلی، علیرغم عملکرد عالی در معیارها، هنوز قادر به درک عقل سلیم و استدلالهای مرحلهای انسانی نیستند.
- ۶. هزینه (Cost): ساخت، آموزش و نگهداری مدلهای DL نیازمند دادههای عظیم، سختافزارهای گرانقیمت (GPU) و زمان زیاد است. همچنین، استنتاج مدلهای حجیم میتواند باعث ایجاد تأخیر (Latency) در سیستمهای حساس شود.
- ۷. استقرار روی دستگاه (On-device deployment): در بسیاری از کاربردها (مانند موبایل)، محدودیتهای سختافزاری اجازه استفاده از مدلهای سنگین DL را نمیدهد و راهحلهای عمومی هنوز با چالشهای زیادی روبرو هستند.
در اکثر پروژههای صنعتی، این چالشها منجر به چرخههای طولانیتر پروژه، هزینههای بالاتر و گاهی بازگشت ضعیف سرمایه (ROI) میشود.
نتیجهگیری: بر اساس این بحث، مشخص است که DL همیشه راهحل اصلی نیست. به همین دلیل، تسلط بر اصول اساسی NLP—از سیستمهای مبتنی بر قانون گرفته تا مدلهای پیشرفته—بسیار مهمتر از صرفاً استفاده از مدلهای پیچیده است. ما باید بر الزامات داده و خط لوله مدلسازی تأکید کنیم و از دنبال کردن کورکورانه مدلهای جدید بدون درک کافی (Context) پرهیز نماییم.